Как решить проблему контекста в агенте
-
Если удобнее смотреть, всё это есть у меня в видео на ютюбе, разбор контекста там идёт с 1:39:34
Все материалы к ролику лежат у меня в тг-канале, залетайте: t.me/mustangbas
План
- Что такое контекст
- Как потеря контекста выглядит на практике
- Как агент сжимает диалог
- Почему от длинного контекста агент тупит
- Сколько токенов уходит на большой проект
- Как уменьшить потерю контекста
- Вывод
Что такое контекст
Контекст это, по сути, весь набор инфы, который доступен модели в какой-то момент. Туда входит:
- данные нашего проекта
- наши запросы и сообщения
- документация всех модулей BAS
Вот со всем этим на руках модель и принимает решение что делать с проектом, отдаёт его BAS, ну и уже BAS встраивает это в софт
Если совсем просто, это как рюкзак, в который влезает шесть книг. Шесть туда положили, и он полный. Захотели добавить седьмую, значит, какую-то из старых надо выкинуть, иначе она физически не влезет. Агент в BAS работает похожим образом: как только в него пытаются запихнуть новую инфу, он сбрасывает старую
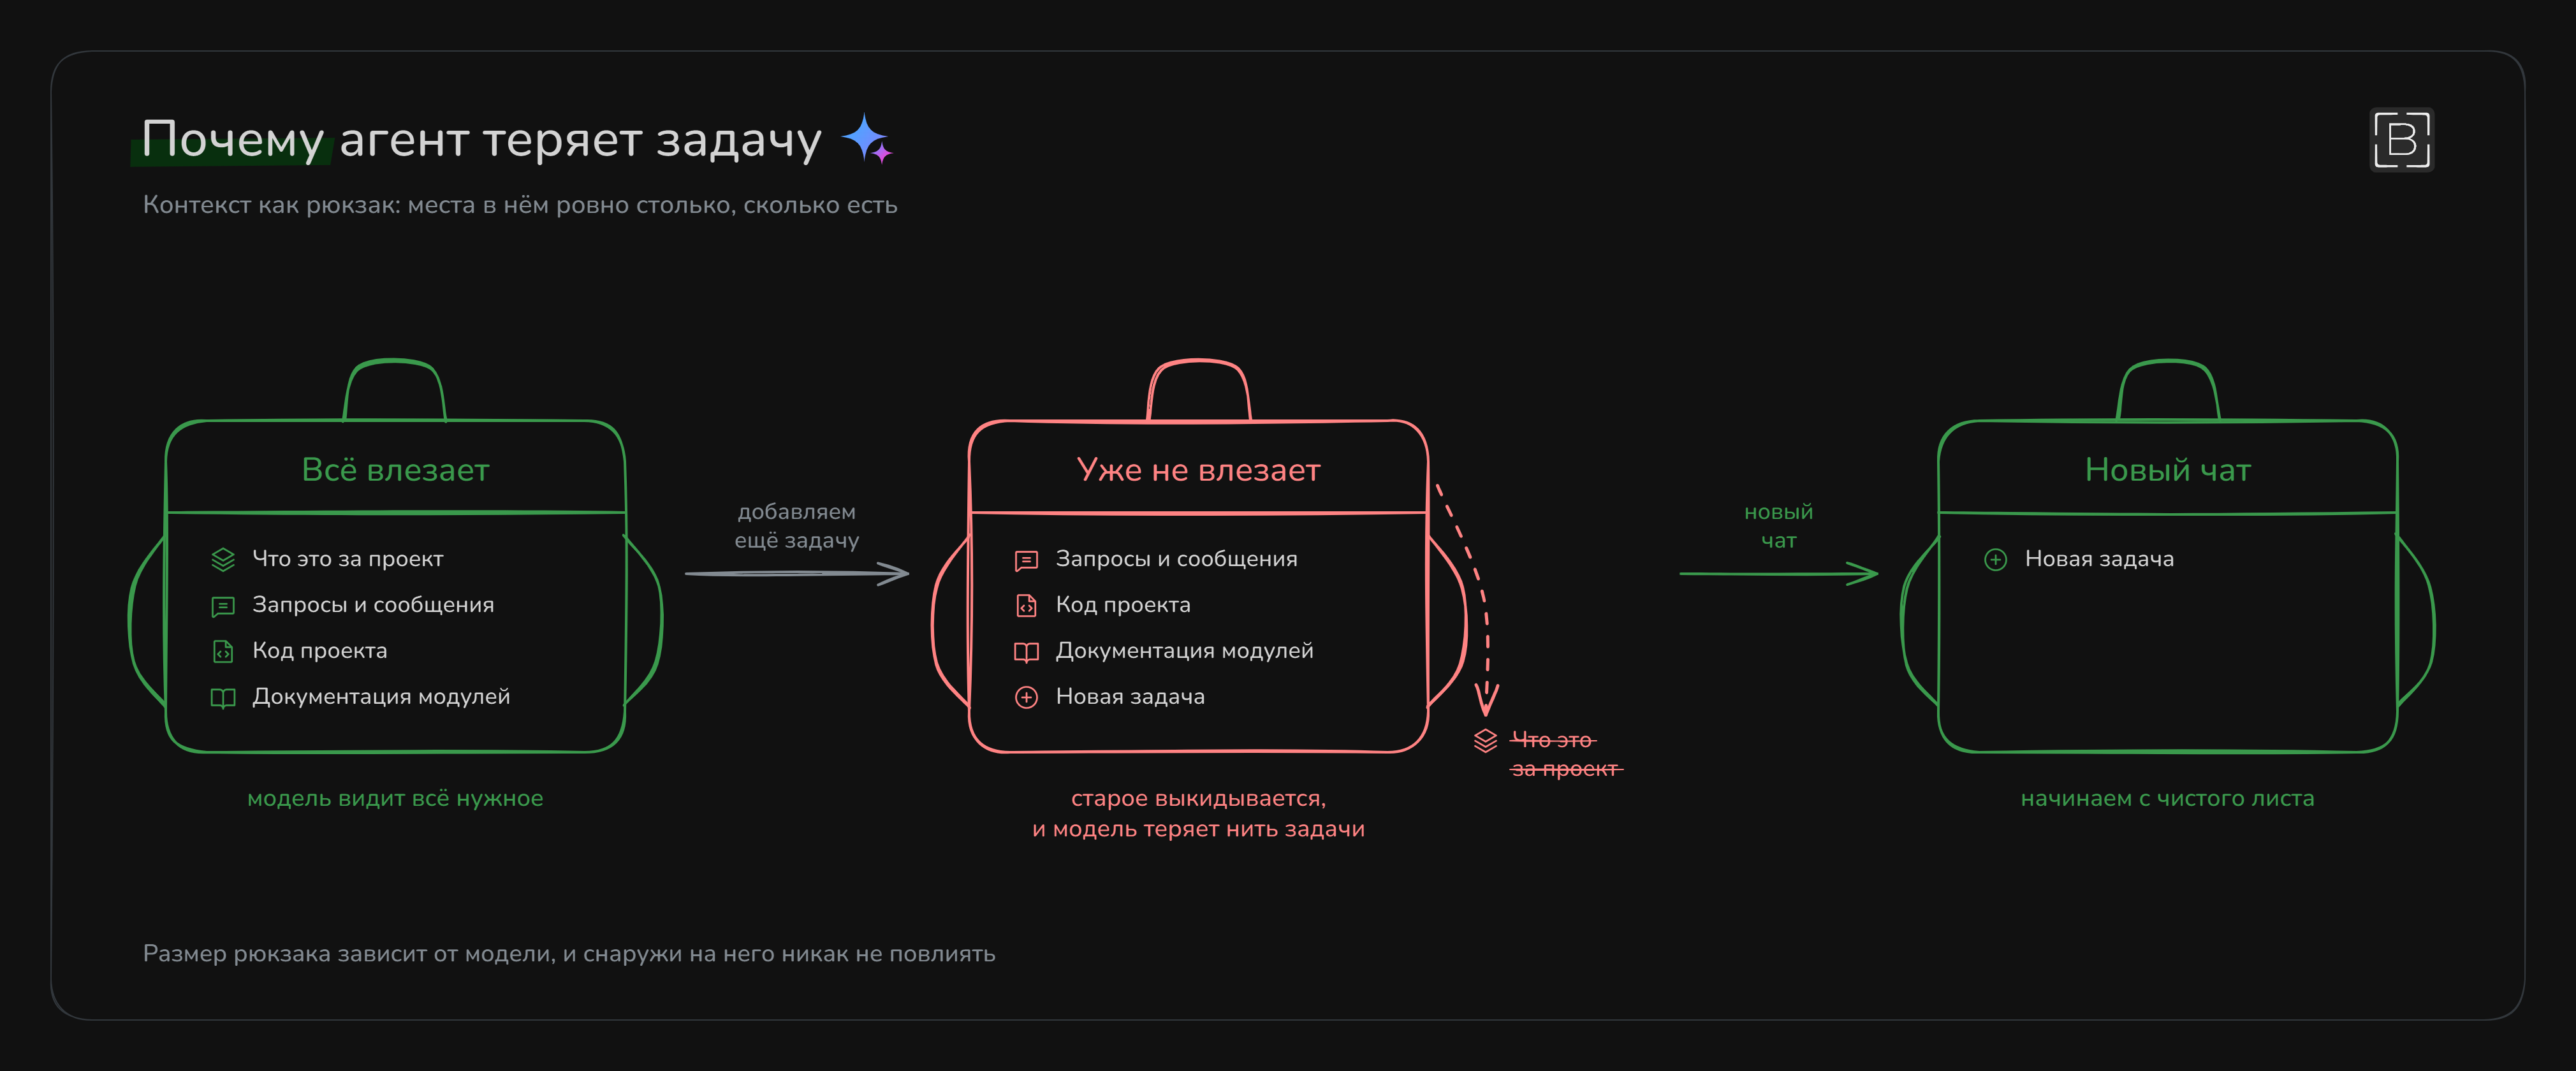
Вместимость рюкзака у каждой модели своя. Считается она в токенах, один токен это примерно 4 символа английского текста, ну и 100 тысяч токенов выходит где-то 150 страниц. У каких-то моделей окно в миллион токенов, у других 200 тысяч или даже меньше
Как потеря контекста выглядит на практике
Мне скинули проект другого разработчика на 6500 действий, и я захотел полностью его переделать. Задачи агенту я давал по очереди:
- Объяснить, что это вообще за проект и как он устроен
- Разложить ресурсы по вкладкам и перевести их на английский
- Составить план, как переделать весь проект целиком
- Из этого плана сделать три задачи:
- переименовать функции и переменные ВСЕГО проекта (161 функция)
- добавить описание КАЖДОЙ функции (тоже 161 функция)
- накидать побольше логов по ВСЕМУ проекту (6438 действий)
Первые две он сделал нормально, ну и самое интересное началось на третьей и четвёртой. Результата я там добивался далеко не одним сообщением. Если пролистать чат, там прям огромная куча промтов, и многие из них по сути про одно и то же
Тут логичный вопрос, зачем вообще писать агенту одно и то же, если всё уже было в первом промте. Всё дело в том самом рюкзаке, контекст у агента ограниченный. Чем дальше он делает работу, тем больше шанс, что он потеряет и сам проект, и изначальный промт
Выглядело это примерно так. План агент сам составил, там было расписано, какие переменные как переименовать. Потом в какой-то момент он пишет, что сохранённого плана в проекте нет, и просит прислать ему список. Ну и я скидываю ему тот самый список, который он же раньше и отправлял
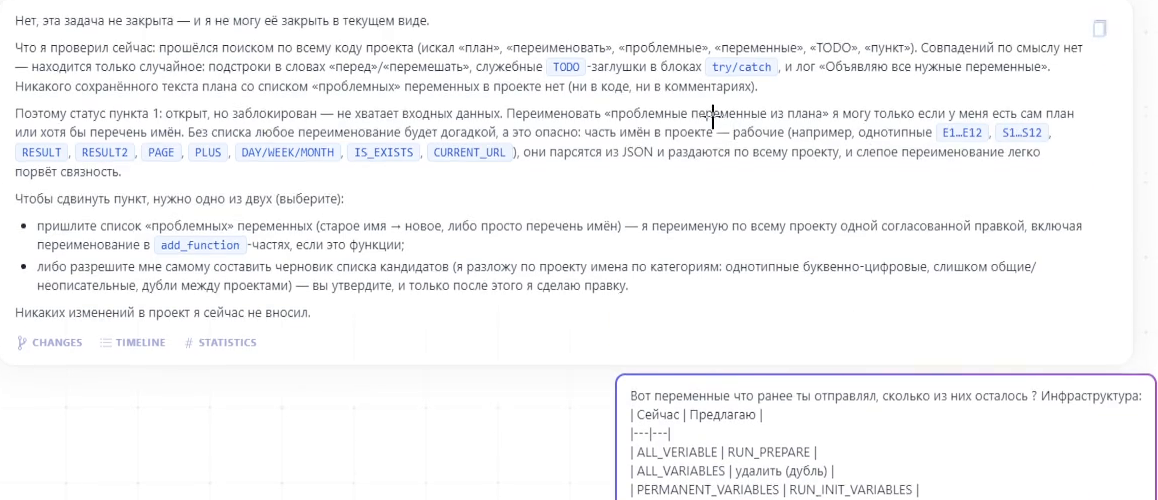
Плюс он часто останавливался, и мне приходилось запускать его заново
Под конец ещё была история с логами: в отчёте агент написал, что задача по логам закрыта на 70%, при этом новых логов в проверенных функциях я не увидел. Скорее всего, он посчитал своими те логи, которые до него оставил человек
Как агент сжимает диалог
Весь диалог целиком агент модели не отправляет. Он постоянно делает краткую выжимку по старым сообщениям, ну и дальше модель работает уже с ней. Какой там конкретно механизм, я не знаю, сервер от нас закрыт. Повлиять на это мы тоже никак не можем
Почему бы не отправлять всё целиком? Для разработчика это было бы очень дорого по ресурсам: обрабатывать такое число обращений и чатов, где каждое тянет за собой всю историю. Так что выжимка это, по сути, чисто оптимизация
Из-за этого при каждой выжимке часть деталей теряется. На длинном диалоге контекст теряется прям сильно, и в какой-то момент из выжимки вылетает что-то важное, типа того самого плана
Посмотреть, сколько контекста уже потерялось, кстати, негде. Во вкладке Statistics под ответом видно модель и токены по запросу, ну и всё. Какое у модели окно, сколько от него занято и что агент выкинул при выжимке, нигде не показано
Почему от длинного контекста агент тупит
Тут есть ещё один момент. Даже если шесть книг влезли, таскать такой рюкзак тяжело, и всё время хочется положить туда поменьше. С моделью то же самое: чем меньше в неё загружено токенов, тем лучше она распоряжается этой инфой и тем лучше решения принимает
Пока загрузка маленькая, условно тысяч 5 токенов, модель работает нормально. Чем больше задач на неё накидывать, тем хуже она соображает, и в какой-то момент она начинает галлюцинировать, то есть просто придумывать то, чего нет
На том большом проекте это было видно прям наглядно. Я нагрузил модель настолько, что у неё как бы вылетели две книги из шести, ну и как раз в них было всё самое важное: что это за проект и что он делает. После этого нить задачи она потеряла, и логи, которые раньше внёс человек, посчитала своими
Сколько токенов уходит на большой проект
Цифры по этому диалогу есть в скачанном логе, и там хорошо видно, как раздувается каждое обращение к модели
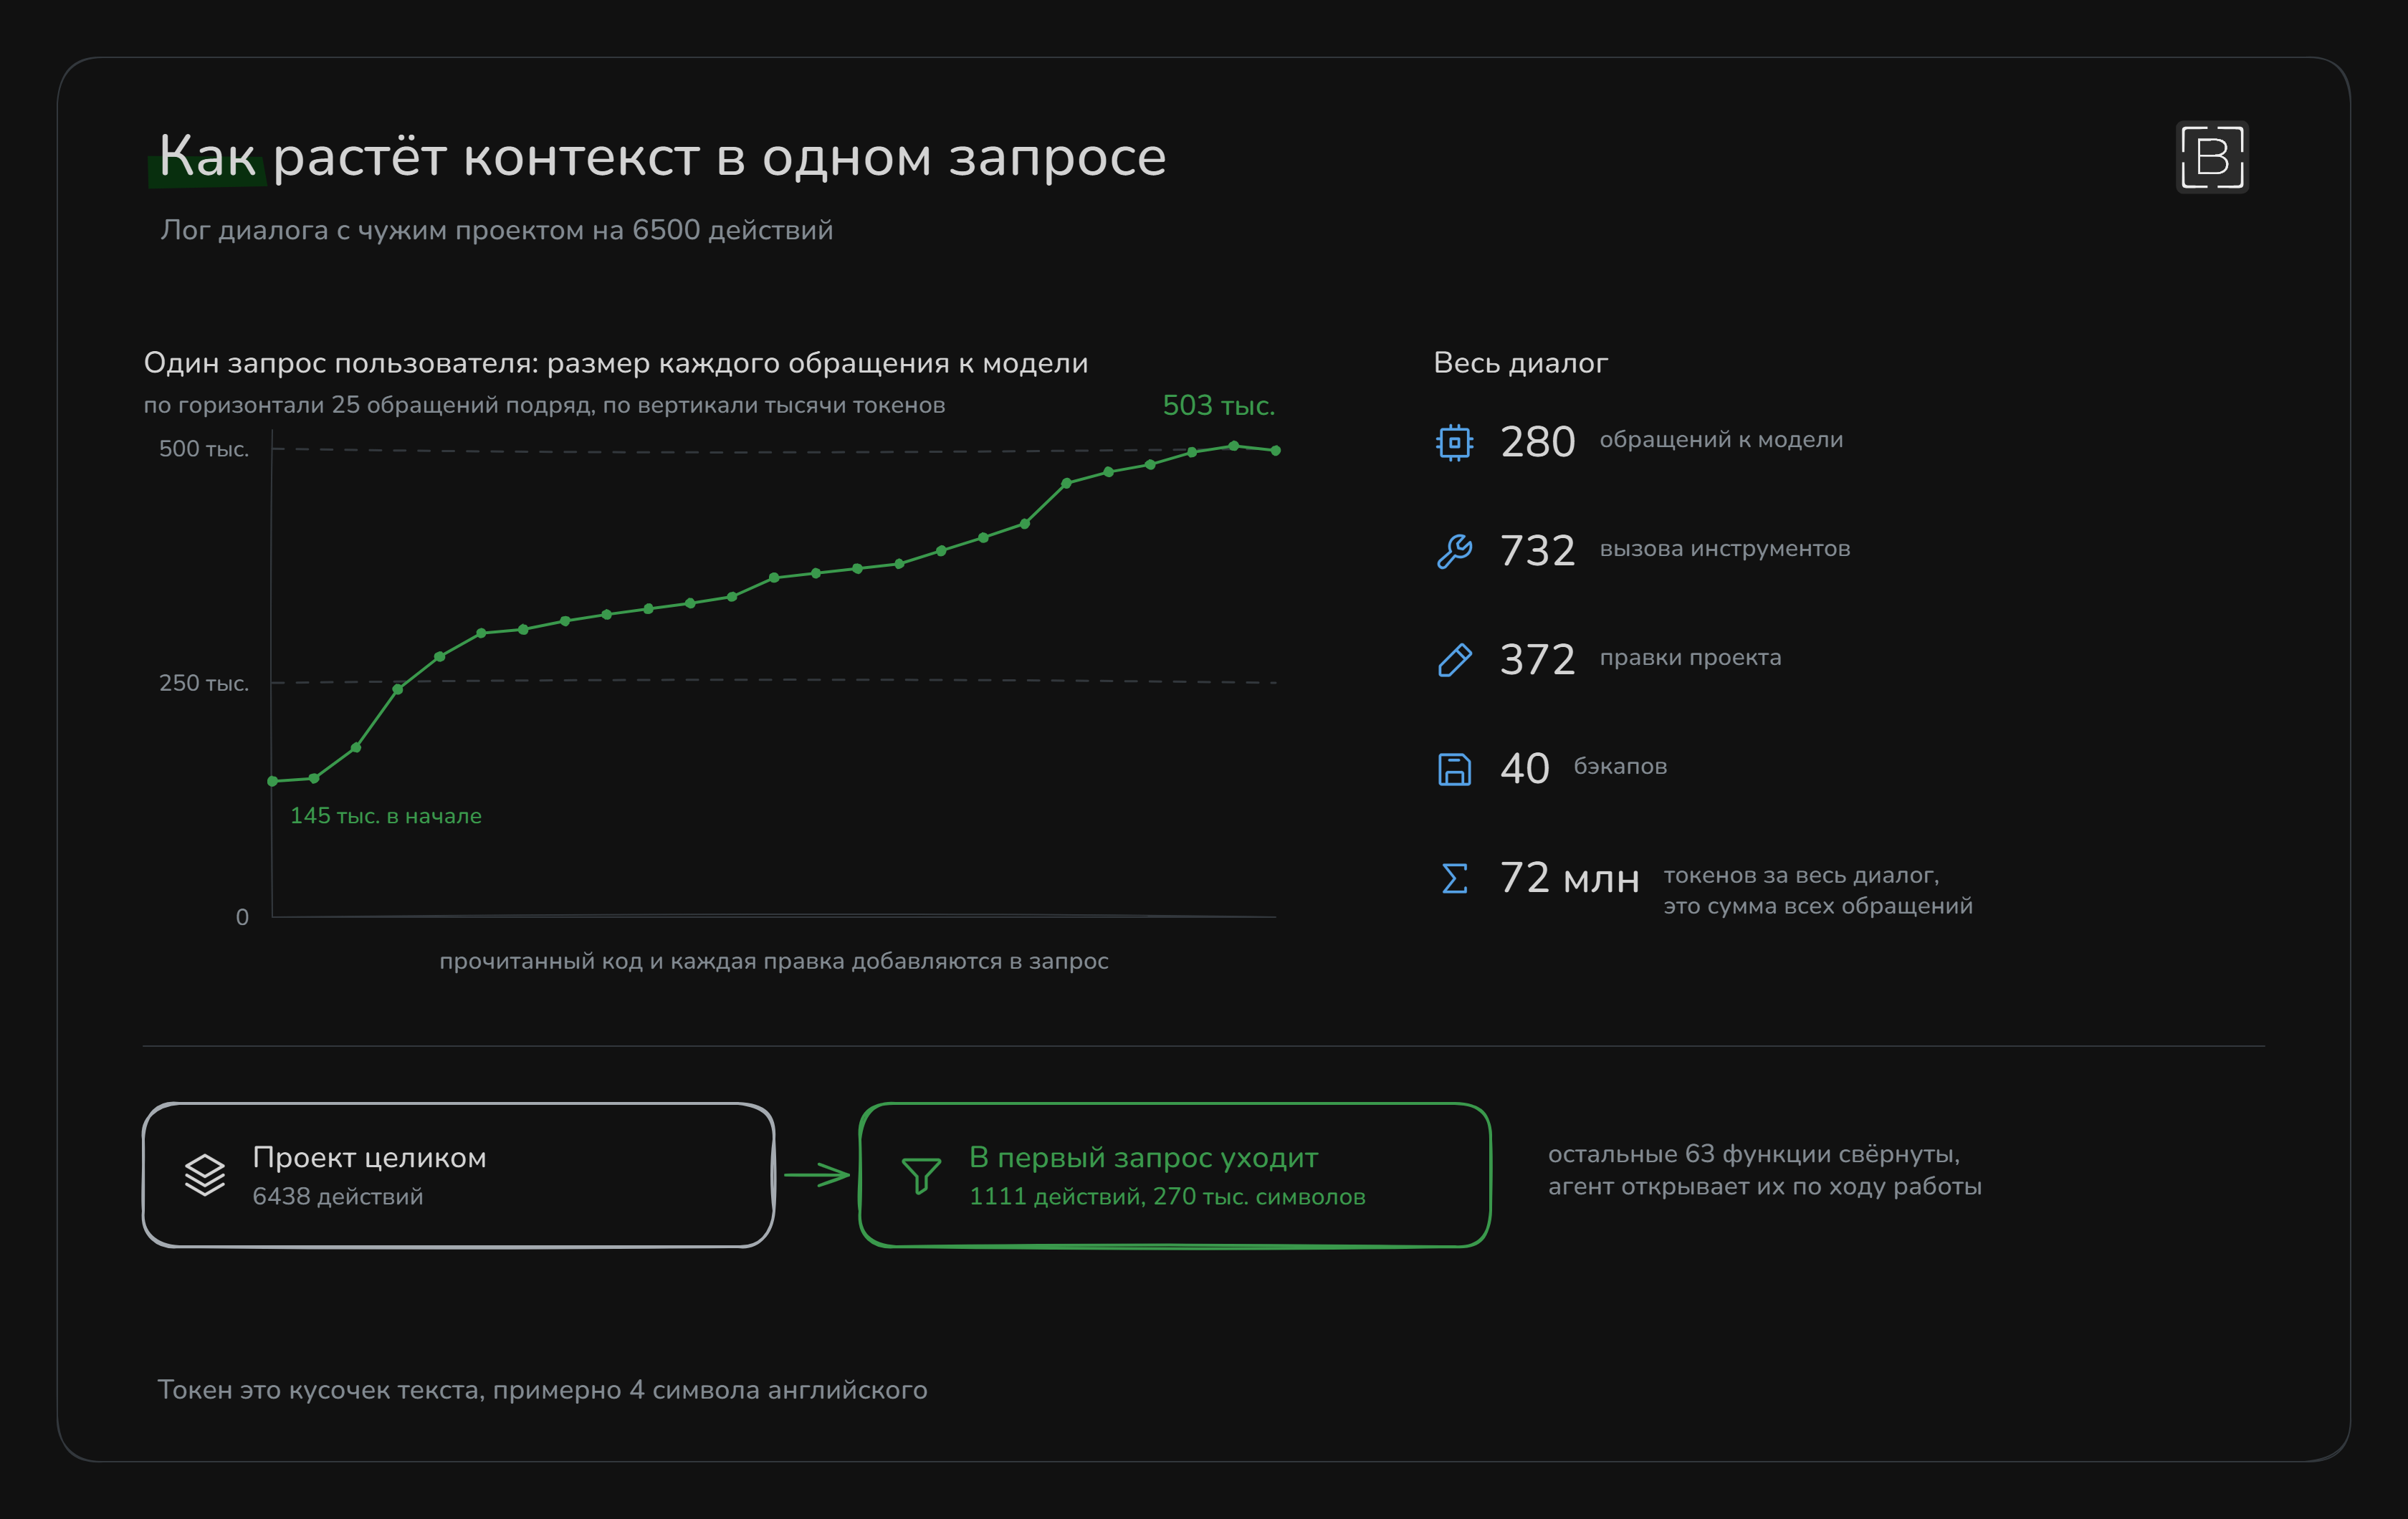
Что там по цифрам:
- в одном моём запросе агент сделал 25 обращений к модели подряд, и размер обращения вырос прям со 145 до 503 тысяч токенов
- в целом за диалог набежало 280 обращений, 732 вызова инструментов, 372 правки проекта и 40 бэкапов
- около 72 миллионов токенов это, по сути, сумма по всем 280 обращениям вместе
Что из этих цифр понятно:
- даже один запрос, по сути, раздувается в три с лишним раза, потому что каждый прочитанный кусок кода и каждая правка добавляются в обращение
- 503 тысячи токенов это уже больше окна многих моделей, так что без выжимки тут никак, ну и часть деталей по дороге теряется
- большой проект съедает прям огромное количество токенов, для разработчика это реально дорого, поэтому он и экономит на контексте
Как уменьшить потерю контекста
Сразу скажу, взять и забустить решения модели в несколько раз мы никак не можем. Именно системой контекста агента занимается разработчик, и мы на неё в целом вообще никак не влияем
Кое-что под нашим контролем всё равно есть:
- одна большая задача в одном чате
- большую задачу разбивать на этапы. Это реально правильный подход к работе с агентом, особенно если проект огромный или задача новая и здоровая
- держать короткий план. Если непонятно, как его вообще составить, можно спросить у самого агента, он распишет подробно, что можно сделать. Я на большом проекте так и сделал, он сам составил план, как переделать проект по этапам
- мелкие и средние задачи можно спокойно делать в одном чате, особой роли это, в целом, не сыграет. Разве что на слишком длинном чате модель, возможно, начнёт тупить. Это не на 100%, как там всё оптимизируется на сервере у разработчиков, непонятно
Почему новый чат так помогает, удобно объяснить на тех же книгах. Допустим, в рюкзаке уже лежат математика, химия и биология, и туда докидывают физику с задачей именно по физике. Чтобы её решить, агент всё равно будет читать старые книги и брать их в расчёт, и это его путает
В новом чате старых книг нет. Мы начинаем с чистого листа, где лежит одна книга, и агент работает намного лучше, потому что не путается в том, что к задаче вообще не относится
Вывод
То, что контекст может так сильно теряться, я считаю одним из главных минусов агента. Выжимку диалога мы не контролируем, и сколько уже потерялось, нигде не видно. Пользователям это никто особо не объясняет, и тут разработчикам, если по уму, надо было бы рассказать, как с этим работать
На проекте другого разработчика из трёх задач агент справился с переименованием и описаниями функций, ну и с логами уже нет. По всему проекту вышло, как по мне, процентов на 40, может на 50
Если бы у меня реально была цель довести его до 90% и было время, ну, дня два сидеть только с ним, я бы разбил всё на этапы с планом, правильным контекстом и нормальным промтом. Я на 100% уверен, что тогда проект агент переделал бы полностью, это просто вопрос времени